article detail
엔비디아 "LLM에 긴 문맥 꼭 필요하지 않아"…압축해도 성능 유지
2026. 11. 9. 오후 1:28
AI 요약
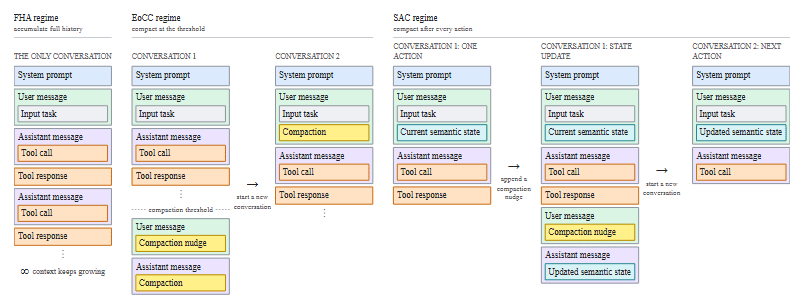
엔비디아 연구진은 지난 3일(현지시간) 아카이브에 긴 문맥이 항상 필요하지 않다고 발표하며, 대화 기록을 압축하거나 대용량 문서에서 필요한 부분만 읽게 하면 짧은 문맥으로도 많은 작업 성능을 유지하면서 추론 처리량을 크게 높일 수 있다고 밝혔습니다. 실험에서 큐원3 코더 넥스트의 컨텍스트 한도를 256K에서 16K로 줄이자 초당 토큰 생성 처리량이 7배 증가했고 GLM 5.2와 키미 K2.6은 각각 3.6배·5.6배 증가했으며, 클로드 오퍼스 4.5와 GPT-5.6 솔은 장기 작업 벤치마크의 대부분 설정에서 전체 기록 유지와 비슷한 성능을 보였고 문서 검색 평가 LOONG에서 클로드 오퍼스 4.5는 16K로 전체 입력보다 점수(79.3% vs 70.1%)와 완벽 정답률(53.4% vs 38.9%)이 개선되었습니다. 다만 일부 모델에서는 성능이 크게 떨어졌고(예: 큐원3 코더 넥스트는 SWE-벤치 베리파이드에서 53.0%에서 3.6%로 하락) 연구진은 문맥을 지나치게 줄이면 성능 저하가 발생할 수 있음을 지적하며 의미 상태 공간 모델(SSSM)을 추후 연구 방향으로 제안했습니다.