article detail
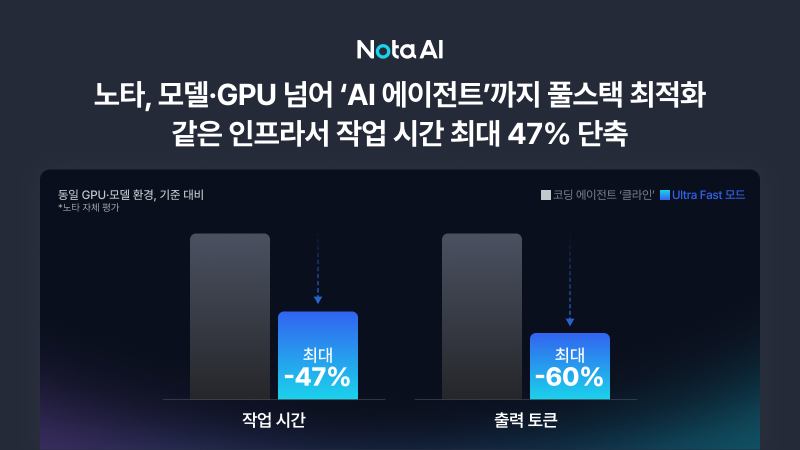
노타, AI 에이전트 작업 시간 최대 47%·토큰 60% 줄인 최적화 기술 공개
2026. 11. 18. 오전 9:56
AI 요약
인공지능(AI) 추론 효율화 기업 노타는 모델 경량화와 GPU 최적화를 넘어 AI 에이전트의 실행 흐름까지 제어하는 ‘풀스택 최적화’ 기술과 에이전트 작업 흐름을 관리하는 ‘하네스’ 최적화를 18일 공개해, 동일한 AI 모델과 GPU 환경에서 코딩 에이전트 ‘클라인’ 기본 구성 대비 작업 시간을 최대 47%, 출력 토큰을 최대 60% 줄였다고 밝혔습니다. 하네스는 최근 응답 길이·파일 수정 이력·도구 실행 결과 등을 분석해 상황에 맞는 추론 강도를 선택하고 이미 통과한 검증과 불필요한 재검토를 줄여 연산 자원을 집중시키며, ‘D플래시2 기반 추측 디코딩’의 반복 문맥 재사용과 GPU 커널 조정, 여러 GPU의 실행 설정 공유로 계산 처리 효율을 높였습니다. 노타는 엔비디아 RTX 프로 6000 4장 환경에서 터미널-벤치 2.1과 SWE-벤치 다국어로 성능 평가를 진행해 ‘패스트’ 모드에서 작업 시간을 최대 32%·출력 토큰 최대 42% 줄였고, ‘울트라 패스트’ 모드에서 작업 시간 최대 47%·출력 토큰 최대 60% 단축했으나 SWE-벤치의 문제 해결률은 65.7%에서 62.0%로 낮아졌으며, 향후 코딩 ���이전트에서 기업용 AI 에이전트와 생성형 AI 서비스로 기술을 확대할 계획이라고 밝혔습니다.